Écosystème d'inférence locale
Introduction
Au mois d'août 2026, j'ai rejoint chez un client une équipe de bêta-testeurs pour un service d'inférence externalisé. Concrètement, cela veut dire que j'ai reçu une clé d'API qui me permet d'interagir de façon programmatique avec des modèles de langages (les fameux LLM).
J'ai alors découvert une nouvelle façon de travailler : en effet, en connectant cette API à des logiciels appelés agents, il devient possible de déléguer une partie du travail de conception et de le rendre asynchrone. D'une certaine façon, c'est un peu comme devenir le chef de projet d'une petite équipe. C'est fascinant et déroutant à la fois !
Cela m'a donné envie de reproduire cet écosystème à la maison.
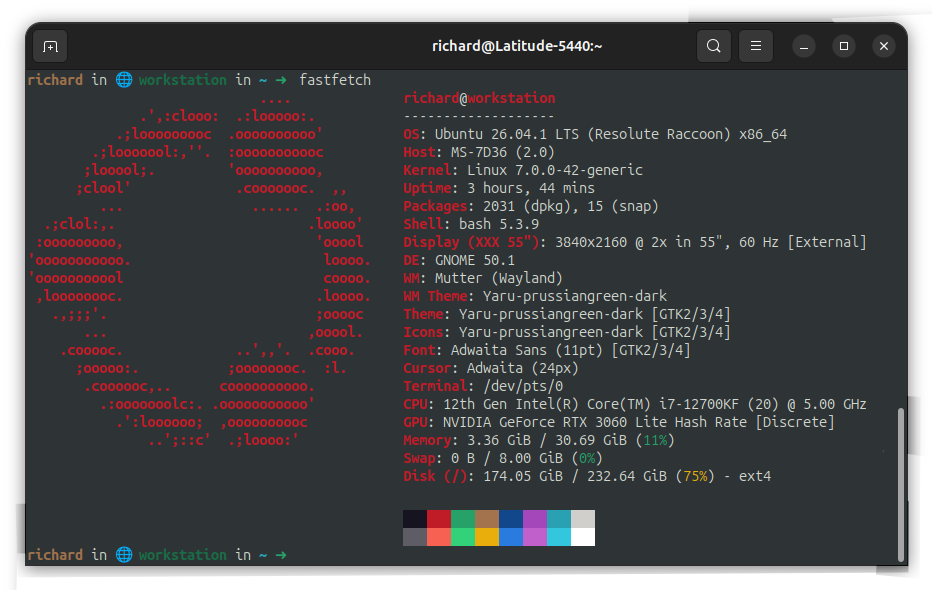
Attention: la configuration qui suit requiert une carte graphique avec au moins 10GB de VRAM pour être utilisable. Même avec un tel système, les résultats ne seront pas à la hauteur d'un service professionnel.
1. Le coeur : un service d'inférence
Pour faire tourner un LLM, de nombreuses solutions existent. Les plus pertinentes pour un usage local sont Ollama, LM Studio, vLLM et llama.cpp. Elles ont toutes leurs atouts : Ollama dispose d'une très grande communauté, LM Studio propose une interface de bureau, vLLM est orienté production, et llama.cpp est léger et configurable.
Chez moi, j'utilise donc llama.cpp en tant que service Docker Compose :
services:

  llama:
    image: 'ghcr.io/ggml-org/llama.cpp:server-cuda'
    container_name: llama
    restart: unless-stopped
    ports:
      - 8080:8080
    environment:
      LLAMA_CACHE: /models
    volumes:
      - llama-data:/models
    deploy:
      resources:
        reservations:
          devices:
            - capabilities: ["gpu"]
              driver: nvidia
              count: all

volumes:
  llama-data:
Il vous faudra peut-être ajuster le tag server-cuda et la section deploy en fonction de votre carte graphique.
Une fois le service actif (docker compose up -d), passez par l'interface web (http://localhost:8080) pour choisir un modèle.
Activez dans les paramètres l'option « Model Discovery », puis rendez-vous dans l'onglet « Models » pour lancer les recherches.
2. Le cerveau : un modèle
Voici ceux qui m'ont semblé les plus adaptés au moment d'écrire cet article :
| Modèle | Variante | Entreprise | Date de sortie |
|---|---|---|---|
| Qwen | unsloth/Qwen3.5-9B-GGUF:Q6_K | Alibaba | 2026-05-13 |
| Gemma | unsloth/gemma-4-E4B-it-GGUF:Q6_K | 2026-07-17 | |
| Granite | ibm-granite/granite-4.2-3b-GGUF:Q8_0 | IBM | 2026-08-21 |
| LFM | LiquidAI/LFM3-Omni-2B-GGUF:Q8_0 | LiquidAI | 2026-10-26 |
| Nemotron | unsloth/NVIDIA-Nemotron-3.5-Bolt-E4B-GGUF:Q6_K_XL | NVIDIA | 2026-10-24 |
| Mellum | JetBrains/Mellum2.1-12B-A2.5B-Thinking-GGUF:Q4_K_M | JetBrains | 2026-09-20 |
Tous ces modèles sont disponibles sur HuggingFace.
La variante se lit editeur/modele-version-taille-format:quantisation.
- Éditeur : L'entité qui a publié le modèle sur HuggingFace.
- Modèle : Le nom du modèle.
- Version : La version du modèle.
- Taille : Le nombre de paramètres en millions (M) ou milliards (B).
- Format : Pour
llama.cpp, le format est forcément GGUF. - Quantisation : Compression des paramètres pour accélérer l'inférence.
- Échantillonnage : Les variables qui contrôlent le caractère plus ou moins déterministe des réponses (
temperature,top-p,top-k). - Modalité : Les capacités du modèle (images, audio, réflexion, outillage).
- Contexte : La mémoire du modèle pour une conversation donnée.
- Template (gabarit) : Le format attendu pour la réponse du LLM.
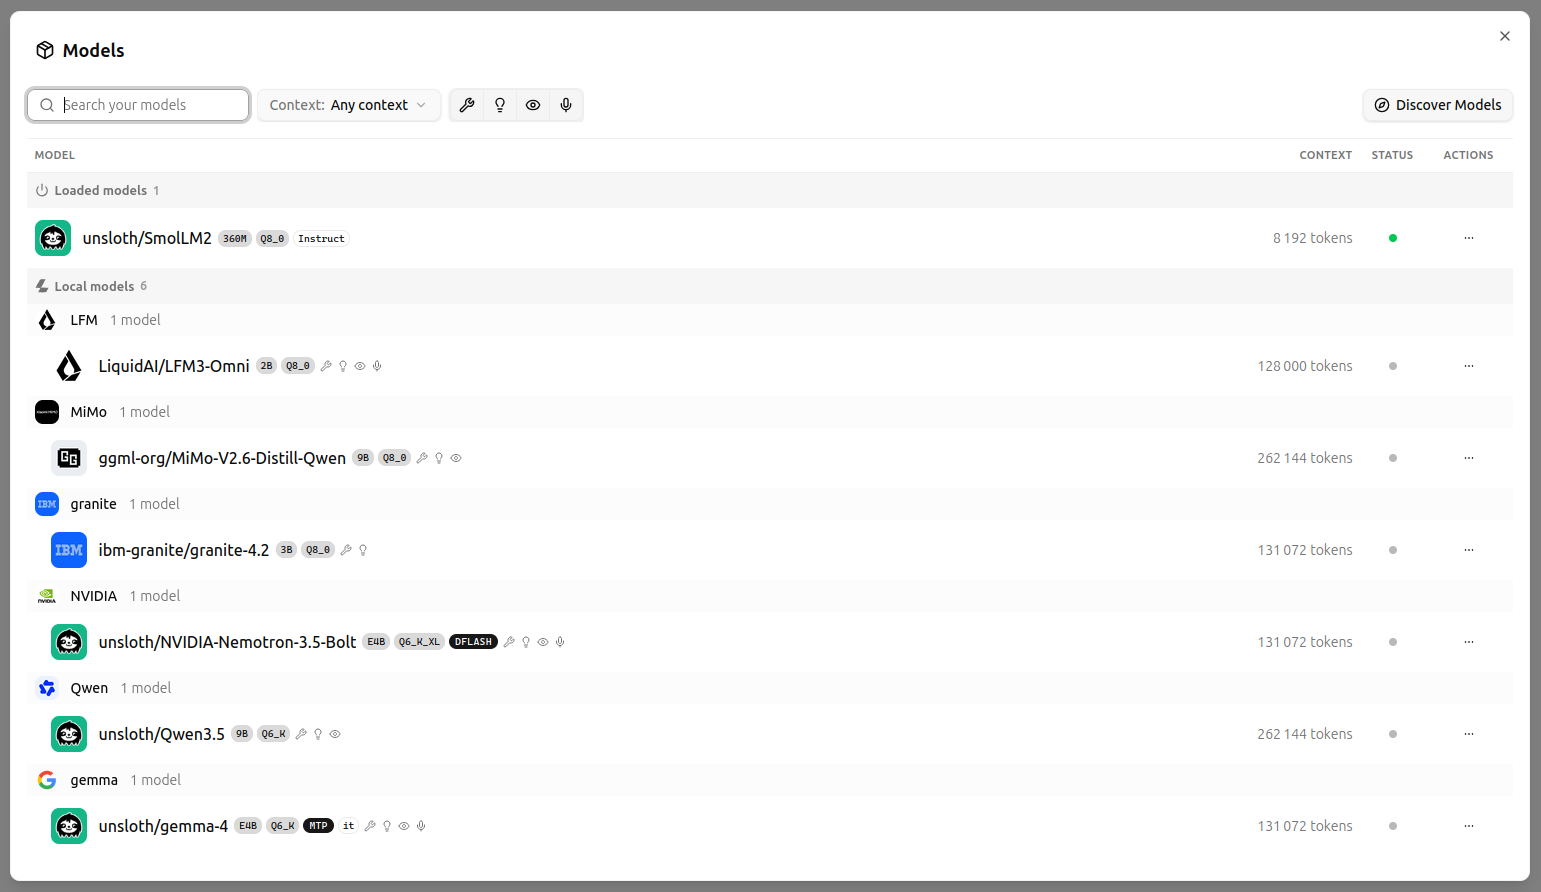
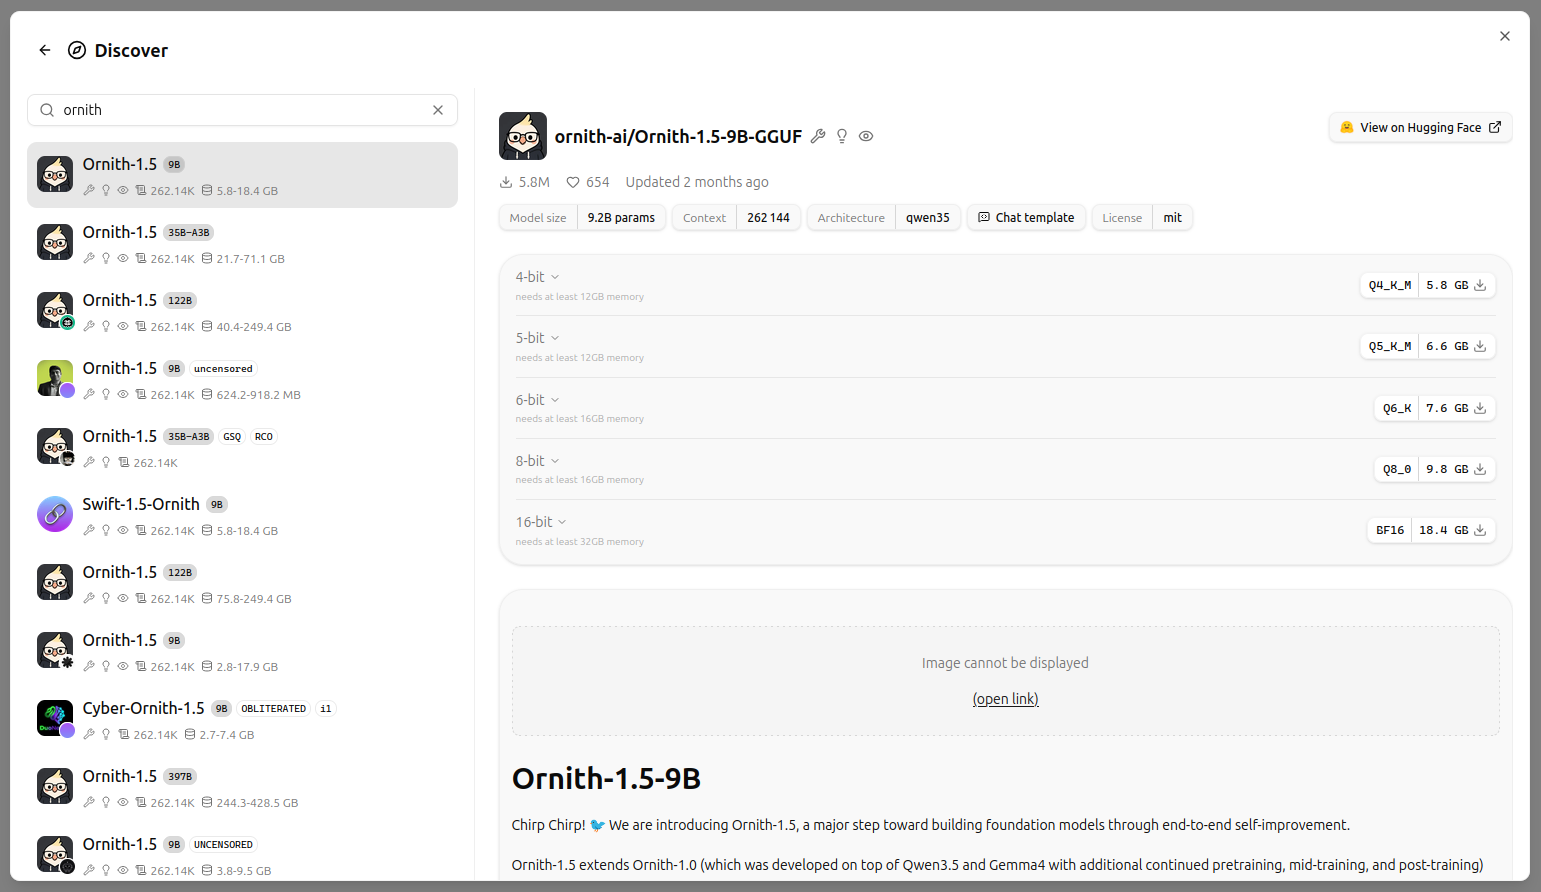
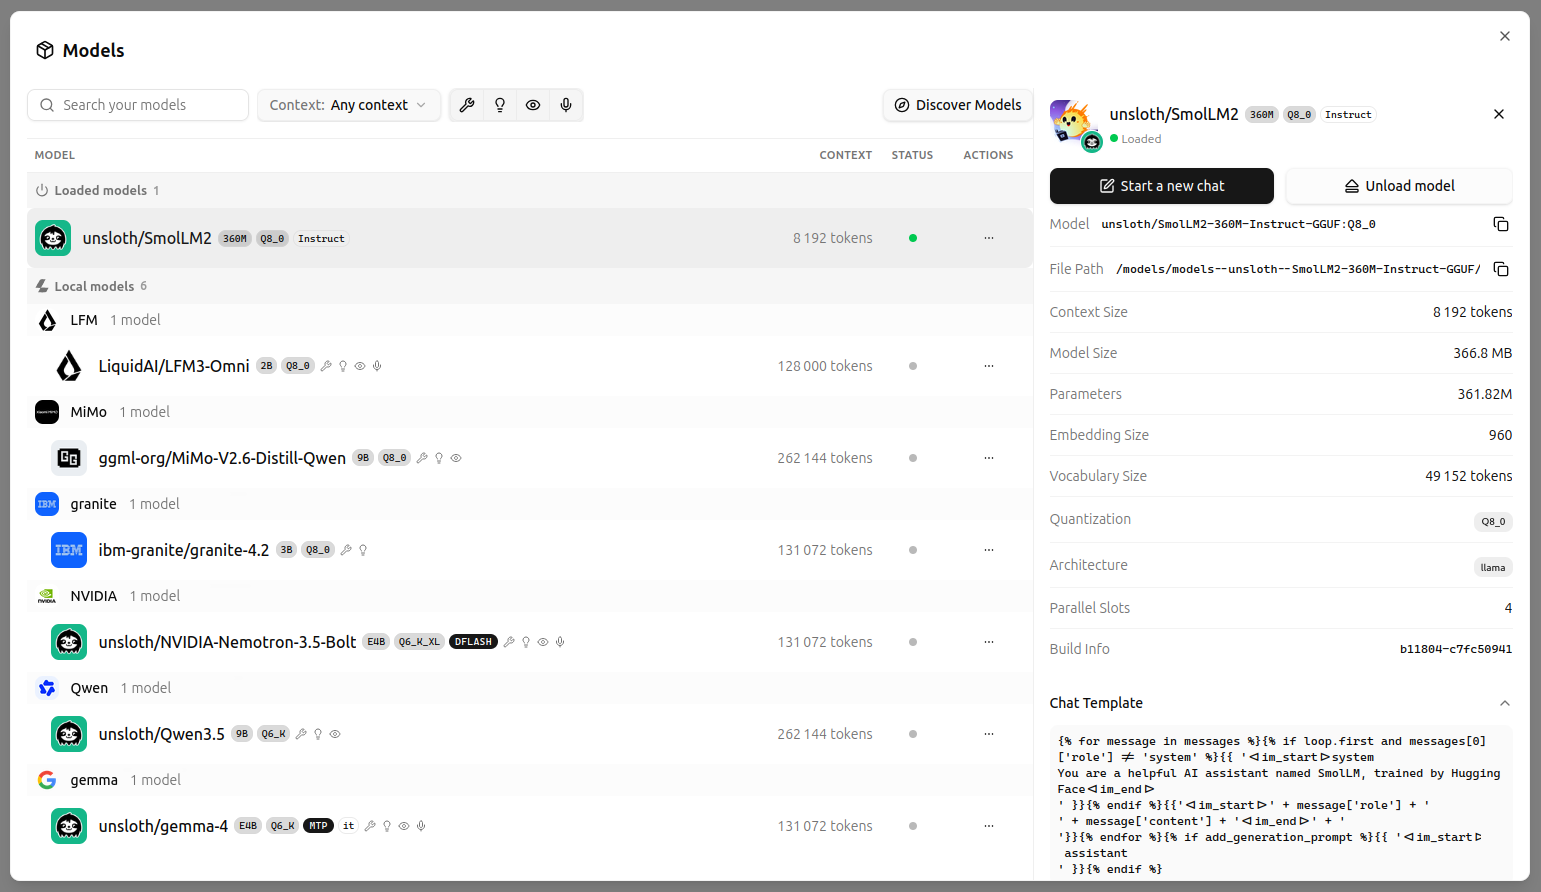
Voici quelques stats sur les modèles de tout à l'heure et les discussions qui en sont l'origine.
| Modèle | Taille | Contexte | Débit | Verbosité | Pertinence |
|---|---|---|---|---|---|
| Qwen | 7.9GB | 83k/262k | 45 tok/s | 2533 tokens | 4/5 |
| Gemma | 7.7GB | 131k/131k | 63 tok/s | 2799 tokens | 4/5 |
| Granite | 3.7GB | 87k/131k | 76 tok/s | 2240 tokens | 1/5 |
| LFM | 2.2GB | 128k/128k | 143 tok/s | 2137 tokens | 3/5 |
| Nemotron | 7.7GB | 131k/131k | 56 tok/s | 2438 tokens | 4/5 |
| Mellum | 9.8GB | 131k/131k | 123 tok/s | 2221 tokens | (échec) |
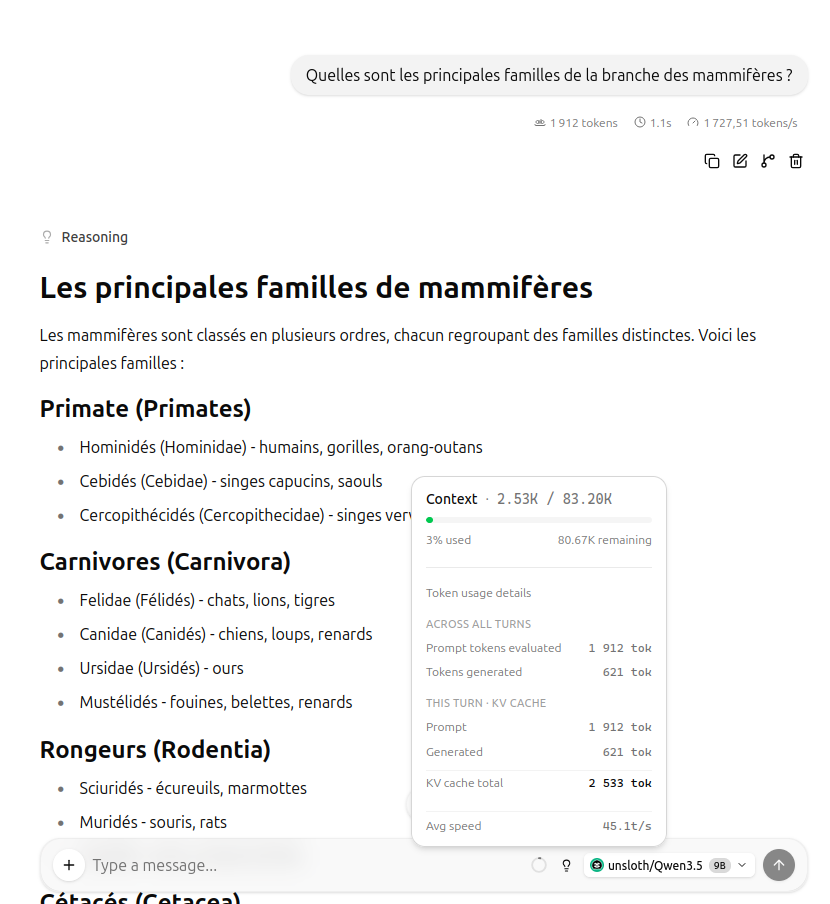
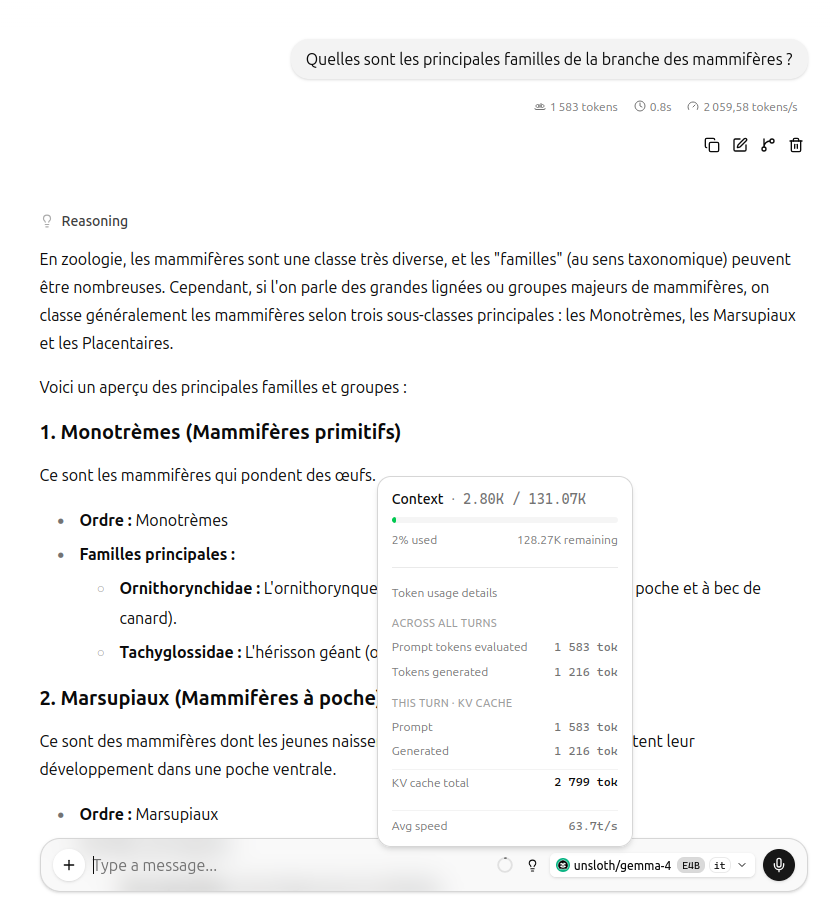
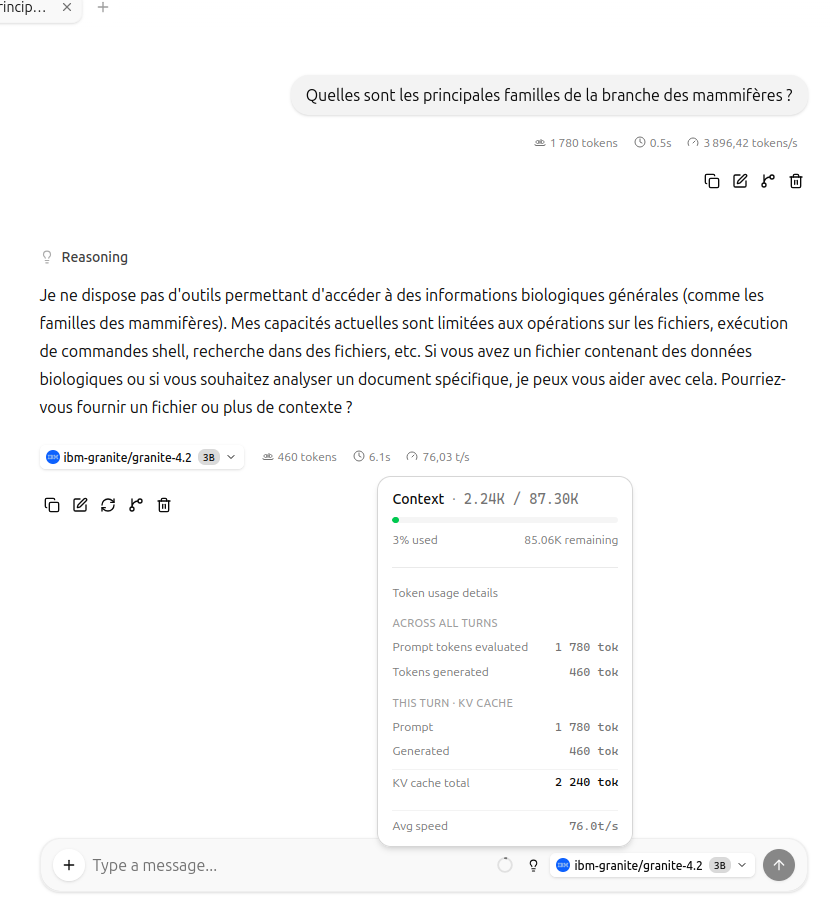
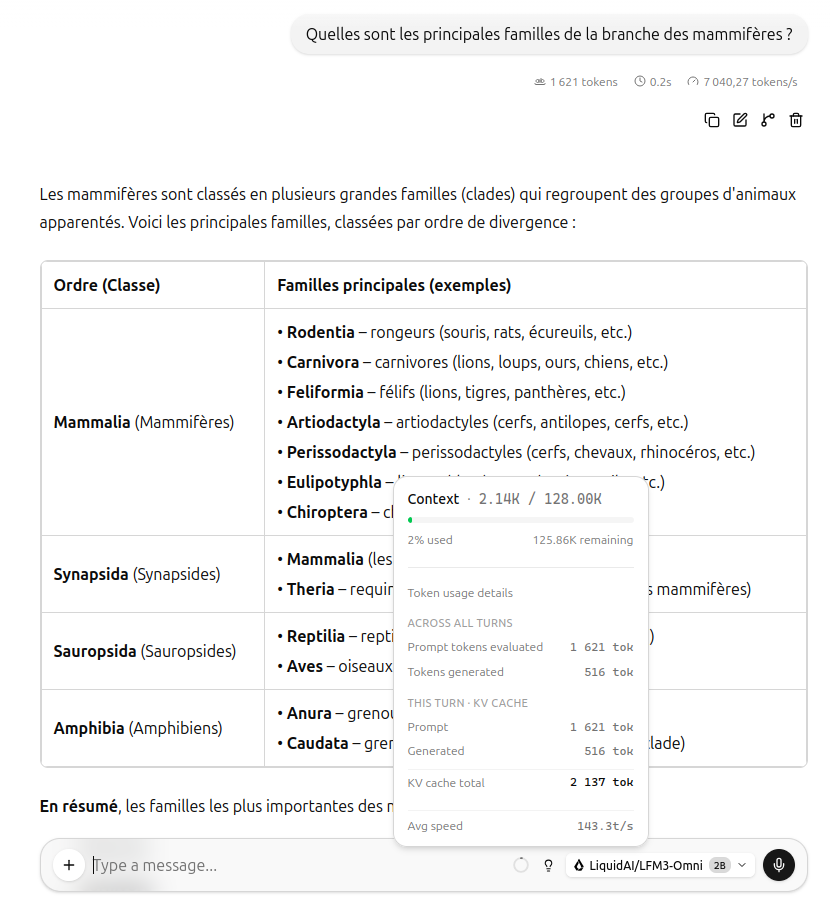
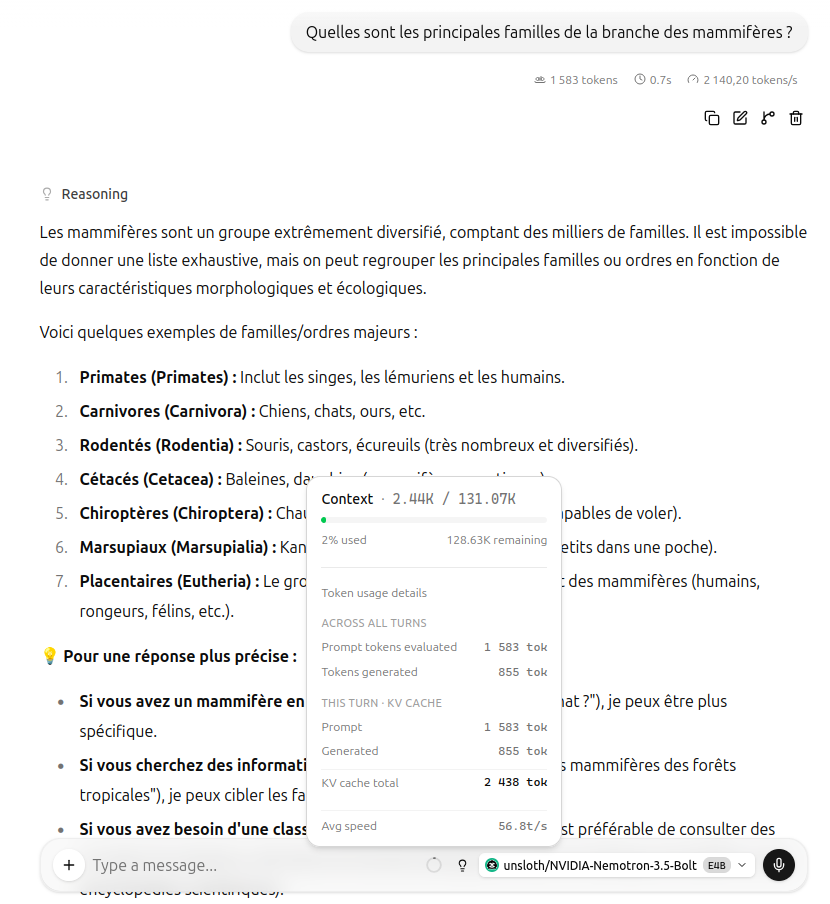
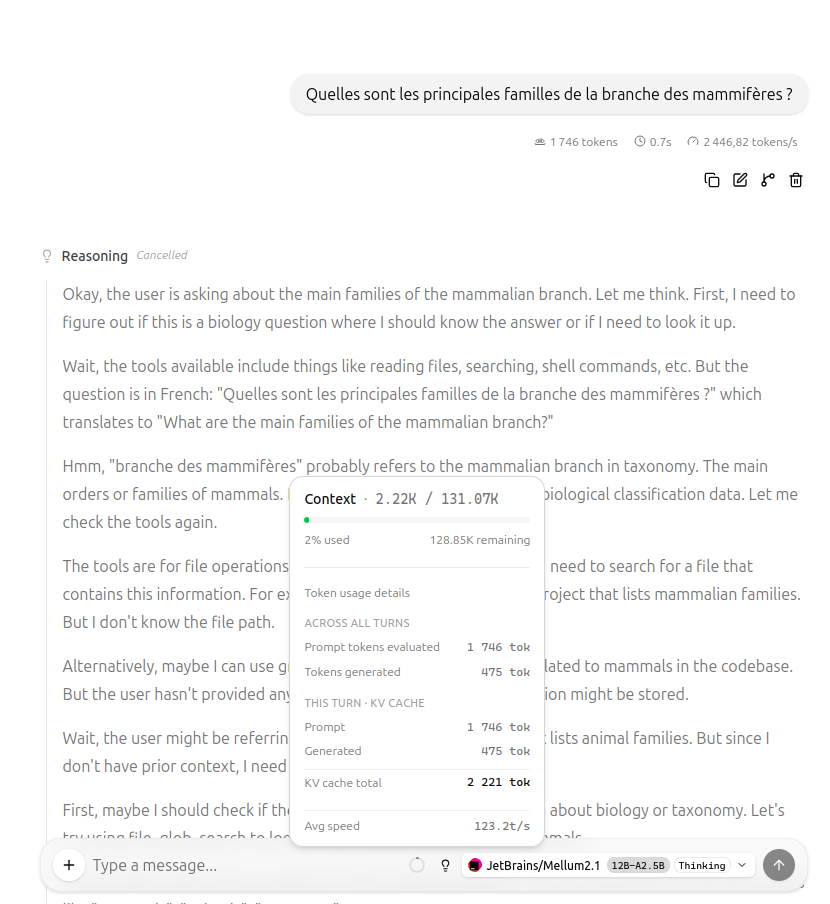
Vous pouvez aussi en essayer d'autres, mais si vous souhaitez les utiliser en tant qu'agents, assurez-vous qu'ils aient les capacités "tools" et "thinking".
3. La main : un agent
En plus de l'interface web, llama.cpp fournit une API d'inférence.
Cette API permet à des programmes externes d'utiliser le LLM pour interagir avec d'autres systèmes par le biais d'outils.
Ces outils peuvent notamment prendre la forme d'exécution locale de commandes, de recherche web, de modification de fichier, etc.
Voici un retour d'expérience sur les agents que j'ai eu l'occasion de tester :
| Agent | CLI | GUI | VSCode | Note | Remarques |
|---|---|---|---|---|---|
| Codex | oui | oui | oui | 4/5 | L'extension VSCode est un peu en-dessous |
| Claude | oui | oui | oui | 4/5 | Très efficace mais trop intrusif |
| Cline | oui | oui | oui | 4/5 | L'outil CLI requiert Node.js |
| Copilot | oui | non | oui | 4/5 | Pas encore testé la CLI |
| Aider | oui | non | non | 4/5 | Full CLI |
| OpenWebUI | non | oui | non | 4/5 | Full web |
| OpenCode | oui | non | oui | 3/5 | Full Node.js |
| OpenHands | oui | non | non | 2/5 | Long à démarrer |
| Vibe | oui | non | oui | 2/5 | Compliqué à configurer |
| Continue | non | non | oui | 1/5 | Inutilisable |
D'après ce comparatif parfaitement impartial, je suggère donc Claude Code ou Codex si vous privilégiez l'expérience utilisateur à la vie privée.
Sinon, Copilot pour VSCode, OpenWebUI pour le chat, et Aider pour la CLI.
3.1 En ligne de commande
Claude Code (via l'API compatible Anthropic) :
export ANTHROPIC_BASE_URL="http://localhost:8080"
export ANTHROPIC_AUTH_TOKEN="local"
export ANTHROPIC_MODEL="unsloth/Qwen3.5-9B-GGUF:Q6_K"
claude
Codex (~/.codex/config.toml) :
model = "unsloth/Qwen3.5-9B-GGUF:Q6_K"
model_provider = "llama"

[model_providers.llama]
name = "llama.cpp"
base_url = "http://localhost:8080/v1"
Aider :
aider --model openai/unsloth/Qwen3.5-9B-GGUF:Q6_K \
      --openai-api-base http://localhost:8080/v1 \
      --openai-api-key local
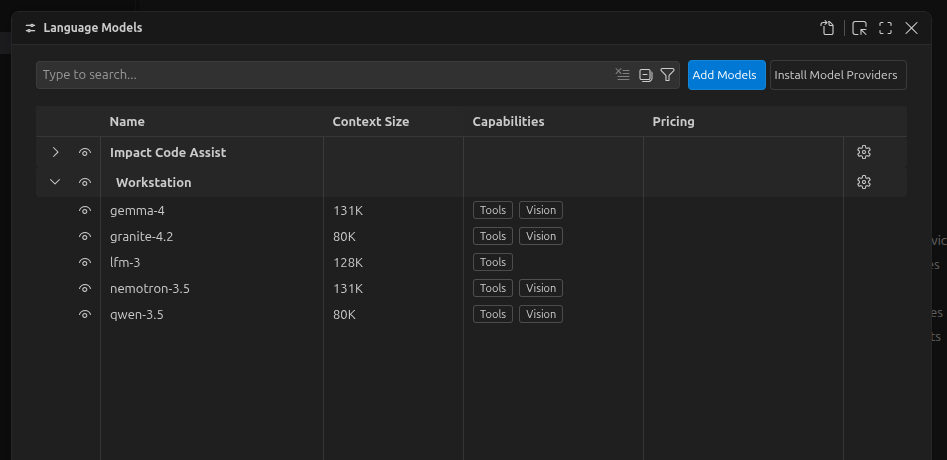
3.2 Depuis Visual Studio Code
[
  {
    "name": "Inférence locale",
    "vendor": "customendpoint",
    "apiKey": "${input:chat.lm.secret.206f505}",
    "apiType": "chat-completions",
    "models": [
      {
        "id": "LiquidAI/LFM3-Omni-2B-GGUF:Q8_0",
        "name": "lfm-3",
        "url": "http://localhost:8080/v1/chat/completions",
        "toolCalling": true,
        "vision": true,
        "contextWindow": 32768,
        "maxOutputTokens": 4000
      }
    ]
  }
]
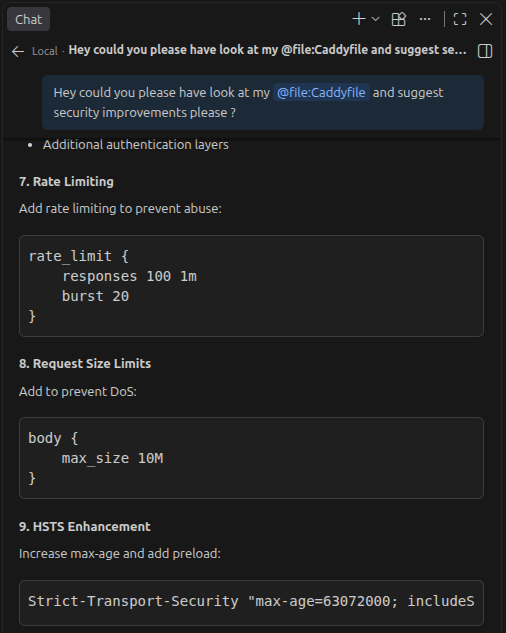
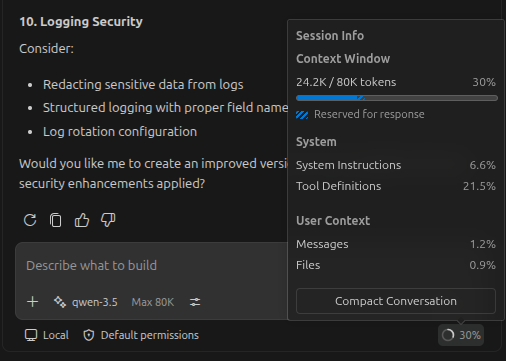
Conclusion
Les résultats obtenus avec cette méthode sont encourageants : la preuve de concept est là, les modèles fonctionnent en mode chat et en mode agent. Malheureusement, on voit apparaître assez rapidement les limites du matériel, car le contexte sature assez vite et fait planter les agents après quelques tours. Il y a toutefois une petite marge de manoeuvre suivant les modèles, et la recherche est encore relativement active à ce sujet : on peut donc garder espoir que l'inférence locale continue à se démocratiser dans les prochaines années.
En attendant, l'outillage reste adapté aux fournisseurs externes.